El thin content es contenido que no aporta valor suficiente al usuario, y no tiene que ver con la longitud. Una página de 200 palabras puede ser excelente y una de 2.000 puede ser thin. Importa porque no afecta solo a esa página: en volumen, arrastra la percepción de calidad de todo el sitio.
Qué es el thin content
Thin content es contenido de escaso valor. La definición de Google es deliberadamente amplia porque el criterio es el usuario: ¿esta página resuelve algo que la persona que la abrió necesitaba resolver?
Si la respuesta es no, es thin, tenga la extensión que tenga.
Thin no es corto: la diferencia entre extensión y valor
Este es el malentendido que más daño hace, porque lleva a la solución equivocada.
Una página de contacto con la dirección, el teléfono y un mapa tiene 50 palabras y es perfecta: resuelve exactamente lo que buscaba quien entró. Un artículo de 2.500 palabras que da diez vueltas para decir tres cosas obvias que están en otras cincuenta webs es thin, aunque el contador diga lo contrario.
La consecuencia práctica: alargar una página delgada no la arregla. Añadir 800 palabras de relleno a una ficha de producto vacía la convierte en una ficha de producto vacía y larga. Lo que la arregla es añadir información que no estaba.
Qué dice Google exactamente (y desde cuándo)
El concepto entró en el vocabulario del sector con Panda (2011), cuyo objetivo explícito era degradar sitios con contenido de baja calidad y granjas de contenido.
Desde entonces, dejó de ser un filtro puntual: se integró en el sistema de evaluación de calidad y hoy funciona de forma continua. Las directrices de calidad de Google siguen listando expresamente varias formas de thin content, y las actualizaciones de contenido útil de los últimos años han reforzado el criterio de «contenido hecho para personas» frente a «contenido hecho para posicionar».
Los seis tipos de thin content
Clasificarlo importa porque cada tipo se arregla de forma distinta.
Contenido autogenerado y traducciones automáticas
Texto producido en masa sin supervisión: generación programática desde plantillas, hilado de sinónimos, o traducción automática publicada sin revisar.
Nota importante y actual: el problema no es la herramienta, es la falta de valor. Google ha dicho explícitamente que no penaliza el contenido por estar generado con IA; penaliza el contenido sin valor, se haya escrito como se haya escrito. Un texto con IA revisado, verificado y enriquecido con criterio propio no es thin. El mismo texto publicado tal cual sale, sí.
Páginas puerta y landings por ciudad clonadas
Páginas creadas para captar variantes de búsqueda que llevan al mismo sitio. El caso más común en España: veinte landings de servicio donde lo único que cambia es el nombre de la ciudad.
El filtro para saber si las tuyas lo son: si puedes hacer buscar y reemplazar del topónimo y la página sigue teniendo sentido, es una plantilla repetida veinte veces. Cómo hacerlas bien está en la guía de SEO local.
Contenido duplicado o copiado del fabricante
El caso masivo del ecommerce: miles de fichas con la descripción que da el proveedor, idéntica a la de otras cincuenta tiendas.
Técnicamente es duplicado, pero el efecto es de thin: tu página no aporta nada que no esté ya en cincuenta sitios. Lo tratamos también en la guía de contenido duplicado.
Páginas de archivo, tag y paginación vacías
El clásico de WordPress. Se crean solas y casi nunca se revisan:
- Tags con un solo artículo, o tags que duplican la categoría.
- Archivos por fecha y por autor que nadie busca.
- Páginas de adjunto: una URL por cada imagen subida, con la imagen y nada más.
- Paginación profunda de listados.
Es el tipo más fácil de arreglar porque se resuelve con configuración, no escribiendo.
Fichas de producto sin contenido propio
Producto con foto, precio, un atributo y nada más. En catálogos grandes es la mayoría del sitio.
No hace falta reescribir 5.000 fichas: se prioriza. Las que venden llevan contenido propio; la cola larga se enriquece con atributos reales y contenido de usuario. El desarrollo está en SEO para ecommerce.
Contenido afiliado sin valor añadido
Reseñas de producto copiadas de la web del fabricante o de otras reseñas, con el enlace de afiliado encima. Google lo dice expresamente en sus directrices: la afiliación no es el problema, la falta de valor propio sí.
¿Penaliza el thin content?
Sí, pero conviene entender de qué forma, porque el mecanismo cambia lo que hay que hacer.
Acción manual frente a ajuste algorítmico
La acción manual existe y se llama literalmente «contenido escaso con poco o ningún valor añadido». Te llega un aviso a Search Console, sabes exactamente qué ha pasado y hay proceso de reconsideración. Es poco frecuente y se reserva para casos graves.
El ajuste algorítmico es lo habitual y lo silencioso. No hay aviso, no hay mensaje, no hay proceso. Simplemente el sitio rinde por debajo de lo que debería, y es indistinguible de «tengo mala suerte» hasta que alguien lo audita.
Si tienes dudas sobre si lo tuyo es una penalización, el diagnóstico está en la guía de penalizaciones de Google.
El efecto sitewide: cómo lo malo arrastra a lo bueno
Esta es la parte que más gente subestima, y es la que justifica el trabajo.
El thin content no afecta solo a la página que lo padece. Cuando una proporción alta de tu sitio es contenido de bajo valor, la evaluación de calidad global baja, y con ella el rendimiento de las páginas que sí son buenas.
Dicho de otra forma: puedes tener el mejor artículo del sector rindiendo por debajo de lo que merece porque comparte dominio con 4.000 páginas de tag vacías. Por eso limpiar suele producir subidas en páginas que no se han tocado, y por eso es de las intervenciones con mejor relación esfuerzo-resultado.
Cómo detectarlo a escala
Aquí está el hueco real frente a los resultados que hoy están por delante en la SERP: todos explican qué es, ninguno explica cómo encontrarlo cuando tienes 20.000 URLs. Este es nuestro procedimiento.
Inventario: crawl + GSC + analítica en una sola tabla
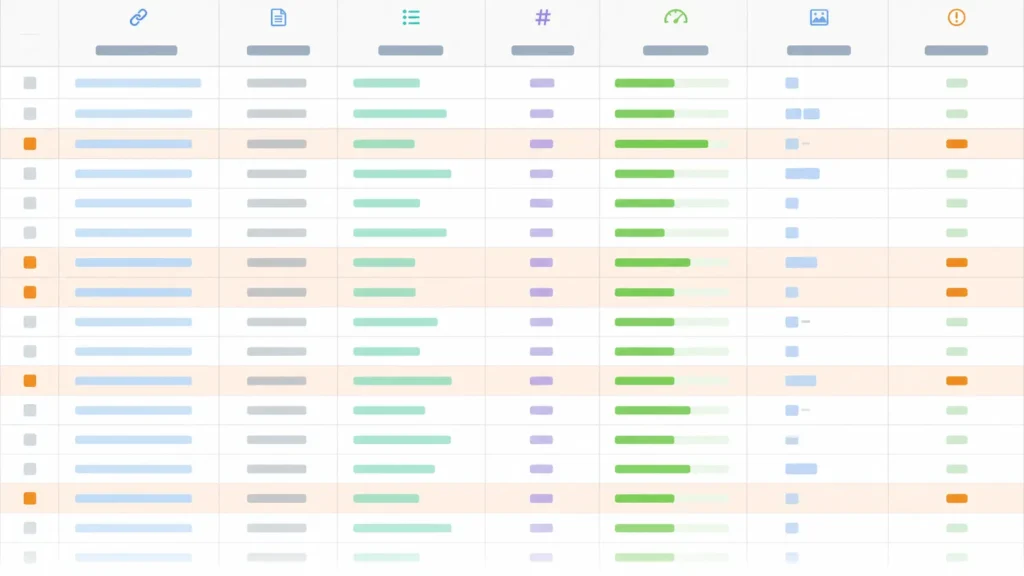
Una sola tabla, una fila por URL, con estas columnas:
Columna | De dónde sale |
|---|---|
URL, código, indexable | Crawl |
Número de palabras del contenido principal | Crawl |
Similitud con otras URLs del sitio | Crawl |
Profundidad de clic y enlaces internos entrantes | Crawl |
Impresiones, clics y posición media (12 meses) | Search Console |
Sesiones y conversiones | Analítica |
Enlaces externos entrantes | Herramienta de backlinks |
El cruce es lo que da el diagnóstico. Ninguna columna sola sirve: la de palabras da falsos positivos y la de tráfico da falsos negativos.
Los umbrales que usamos y por qué
No son leyes, son puntos de partida que luego se ajustan al proyecto:
- Menos de 300 palabras de contenido principal (sin menús, pies ni barras laterales): candidata a revisar, no a eliminar.
- Cero impresiones en 12 meses: señal fuerte. Google la conoce y no la considera relevante para nada.
- Impresiones pero cero clics con posición por debajo de 20: existe pero no compite.
- Cero enlaces internos entrantes: página huérfana. Nadie del propio sitio la considera importante.
- Similitud interna por encima del 70 %: casi-duplicado.
La regla de oro: ninguna página se toca por un solo criterio. Se actúa cuando se cruzan dos o más. Una página de 150 palabras con 4.000 impresiones y conversiones no es thin, es eficiente.
Detectar plantillas repetidas y similitud interna
La función de casi-duplicado de un crawler (habitualmente con un umbral del 80-90 %) es la que destapa las landings clonadas y las fichas con texto de fabricante.
Un truco barato que funciona: coge una frase del segundo párrafo de una landing, búscala entre comillas con site:tudominio.com y cuenta cuántas devuelve. Si salen dieciocho, ya tienes el diagnóstico sin herramienta.
Páginas con impresiones y cero clics
Es la lista más rentable del inventario, porque separa dos problemas que se confunden:
- Posición buena y cero clics: no es thin, es un problema de title y meta. Se arregla en diez minutos.
- Posición mala y cero clics: sí puede ser thin. Google la conoce, la muestra a veces y nadie la elige.
Confundir estos dos casos lleva a reescribir páginas que solo necesitaban un title nuevo.
Qué hacer con cada página: consolidar, mejorar o eliminar
El árbol de decisión
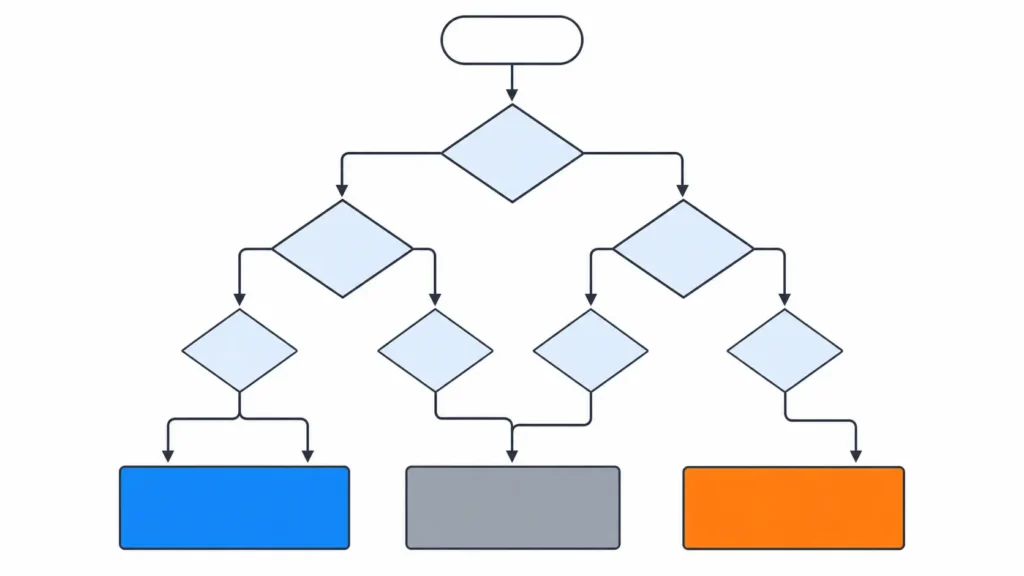
Con el inventario delante, cada URL pasa por estas preguntas en este orden:
- ¿Tiene tráfico, conversiones o enlaces externos? Si sí, no se elimina bajo ningún concepto. Se mejora o se consolida conservando su URL.
- ¿Existe otra página del sitio que cubra lo mismo? Si sí, consolidar.
- ¿Hay demanda de búsqueda real para su tema? Si sí, mejorar.
- ¿Cumple una función aunque no traiga tráfico? (aviso legal, contacto, política de cookies). Si sí, se queda. noindex si procede, pero se queda.
- Si no cumple ninguna, eliminar.
Consolidar: cómo se fusiona sin perder señales
Consolidar es coger dos o más páginas que compiten y hacer una buena.
El procedimiento: elige la URL que se queda (normalmente la que tiene más histórico, no la que más te gusta), lleva a ella lo mejor de las otras, redirige las demás y actualiza los enlaces internos que apuntaban a las viejas.
Ese último paso se olvida siempre. Dejar los enlaces internos apuntando a URLs redirigidas crea cadenas y desperdicia crawl budget.
301 1:1, nunca al hub
Cuando consolidas, la 301 va de cada página a su equivalente concreto, nunca a la home ni a la categoría por comodidad.
Google trata una redirección a un destino no equivalente como un soft 404: no transfiere señales y, en la práctica, tiras a la basura lo que esa URL había acumulado. Si no hay equivalente, es mejor un 410 honesto que una 301 a cualquier sitio.
Mejorar: qué se le añade a una página delgada
No palabras: información. En este orden de rentabilidad:
- Responder lo que la página promete y hoy no responde.
- Datos, ejemplos o casos propios. Es lo único que no puede copiarte nadie.
- Elementos que aportan de verdad: tablas comparativas, capturas, plantillas descargables.
- Las preguntas reales que la gente hace sobre el tema.
- Enlaces internos a lo relacionado, en los dos sentidos.
Eliminar: 410, 404 o noindex
- 410 (Gone): la opción por defecto cuando la página no vuelve y no tenía nada. Google lo procesa más rápido que el 404.
- 404: equivalente en efecto, más lento de procesar.
- noindex: para páginas que tienen que existir para el usuario pero no aportan en búsqueda (filtros, resultados internos, algunas legales). Ojo: sigue consumiendo rastreo.
Nunca borres en masa sin haber cruzado el inventario. Hemos visto proyectos eliminar cientos de URLs por tener pocas palabras y llevarse por delante páginas con enlaces externos.
Un ejemplo real de cómo sale el reparto
Para que se vea cómo funciona el árbol en la práctica, este es el tipo de reparto que nos encontramos en una web de contenido de unas 2.000 URLs:
Grupo | Volumen típico | Decisión |
|---|---|---|
Páginas de adjunto de imagen | 600-800 | Eliminar de raíz (desactivar en el plugin) |
Tags con uno o dos artículos | 150-300 | noindex o fusionar en categoría |
Artículos sobre el mismo tema publicados en años distintos | 40-80 en grupos de 2-4 | Consolidar con 301 1:1 |
Artículos con demanda y contenido flojo | 100-200 | Mejorar |
Artículos sin demanda y sin tráfico | 80-150 | Eliminar con 410 |
Páginas funcionales (legal, contacto) | 10-20 | Se quedan, noindex si procede |
Lo llamativo del reparto no es la limpieza en sí: es que el grupo más numeroso casi siempre es el que se genera solo y no lo escribió nadie. Antes de plantearte reescribir doscientos artículos, desactiva lo que tu CMS está creando a tus espaldas. Es el trabajo de una tarde y suele ser la mitad del problema.
El orden en que se ejecuta
Importa, porque hacerlo al revés genera trabajo doble:
- Primero lo automático: desactivar adjuntos, archivos y tags descontrolados. Barato y masivo.
- Después las consolidaciones: son las que devuelven tráfico más rápido, porque juntan señales que ya existen.
- Luego las eliminaciones de lo que no tiene nada.
- Al final, mejorar lo que merece la pena. Es lo más caro en horas y lo último que toca.
Mucha gente empieza por el punto 4 porque es el más agradecido de contar, y acaba mejorando artículos que compiten con otro artículo suyo que no había visto.
Thin content en la era de la IA
Contenido generado con IA: cuándo es thin y cuándo no
La postura de Google es clara y conviene repetirla porque el sector la deforma: no importa cómo se produjo el contenido, importa si aporta valor.
Un artículo generado con IA, verificado, corregido, enriquecido con datos propios y con criterio de alguien que sabe del tema no es thin. Un artículo generado con IA publicado sin leer es thin, exactamente igual que lo sería escrito a mano sin pensar.
Lo que sí ha cambiado es la escala: producir 500 páginas mediocres cuesta hoy una tarde. Por eso el problema se ha multiplicado y por eso los sistemas de calidad se han endurecido.
Por qué un LLM no cita una página delgada
Hay una razón adicional para limpiar, y es nueva.
Cuando un asistente de IA construye una respuesta, recupera páginas y extrae de ellas la información. Una página delgada no tiene nada que extraer: no hay dato, no hay respuesta concreta, no hay estructura.
Y aquí aplica el marco de siempre: los modelos con búsqueda se apoyan en los resultados de Google, así que quien no rankea difícilmente es citado. El thin content te deja fuera de las dos cosas a la vez, y por el mismo motivo.
Cómo evitar que vuelva
Limpiar sin cambiar el proceso garantiza volver a la misma situación en dos años. Lo que funciona:
- Un estándar mínimo de publicación escrito, no sobreentendido: qué tiene que llevar una pieza para publicarse.
- Desactivar de raíz lo que se genera solo: páginas de adjunto, archivos por fecha y autor, tags sin control.
- Gobernanza de tags: quién puede crearlos y con qué criterio.
- Revisión periódica: dos veces al año, el mismo inventario.
- Regla para el catálogo: qué producto nuevo entra indexable y cuál no.
¿Cuánto thin content tiene tu web?
Casi nadie lo sabe hasta que lo mide, y la cifra suele sorprender. El inventario cruzado de este artículo es exactamente lo que hacemos en una consultoría SEO, con el plan de consolidar, mejorar o eliminar URL por URL y priorizado por impacto.
Preguntas frecuentes
¿Qué es el thin content?
Contenido que no aporta valor suficiente al usuario. No depende de la extensión: depende de si resuelve lo que buscaba quien entró.
¿Cuántas palabras necesita una página para no ser thin?
No hay número. Una página de 100 palabras que responde exactamente lo que se le pide no es thin; una de 2.000 que no dice nada, sí. Usamos las 300 palabras como umbral para revisar, nunca para decidir.
¿El thin content penaliza toda la web?
Puede. Si la proporción de páginas de bajo valor es alta, la evaluación de calidad del sitio baja y arrastra a las páginas buenas. Por eso limpiar suele mejorar el rendimiento de contenidos que no se han tocado.
¿Google penaliza el contenido escrito con IA?
No por estar escrito con IA. Penaliza el contenido sin valor, se haya producido como se haya producido. Un texto con IA revisado y enriquecido con criterio propio no es thin.
¿Borro las páginas con poco tráfico?
No sin cruzarlo antes con enlaces externos, conversiones y función en el sitio. Una página sin tráfico pero con enlaces externos es un activo. Borrarla es tirar autoridad.
¿Las páginas de tag son thin content?
Suelen serlo cuando se crean sin control: tags con un solo artículo o que duplican una categoría. Un tag con veinte artículos coherentes y demanda de búsqueda propia es una página legítima.
¿Cuánto tarda en recuperarse una web tras limpiar thin content?
Con desindexación y consolidación, entre uno y tres meses. Si había acción manual, hasta que se resuelva la reconsideración. En sitios grandes, la recuperación es progresiva a medida que Google reevalúa.