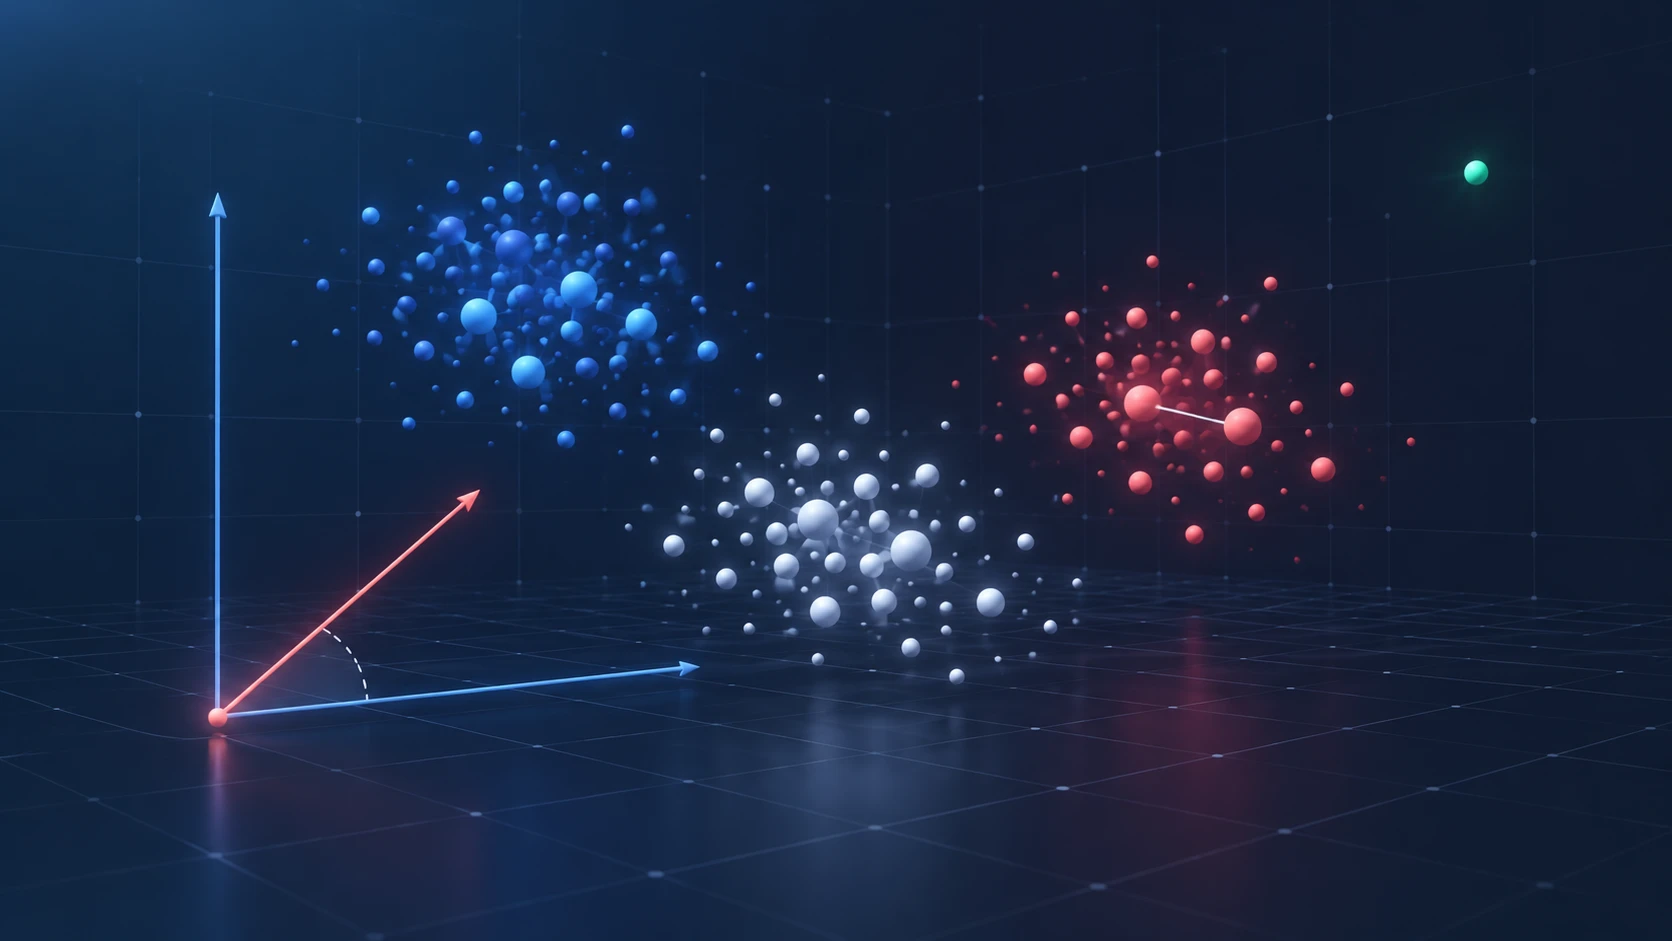
Un embedding es la representación de un texto, una imagen u otro contenido como un vector denso: una lista de números en un espacio vectorial, calculada por un modelo de IA, que deja cerca los contenidos de significado parecido. Sirve para comparar significados y no solo palabras. Piénsalo como las coordenadas de un mapa, pero de significado.
Actualizado el 20 de octubre de 2026.
Qué es un embedding, con un mapa de platos
Un embedding es un punto en un mapa de significado. Para entenderlo, imagina que colocas platos de comida en un mapa. Google lo explica así en su curso de Machine Learning: una primera dimensión imaginaria mide cuánto se parece cada plato a un sándwich (con platos como el perro caliente, la pizza o el borscht). Si añades una segunda, la «postreidad», el strudel de manzana se aleja de los sándwiches, porque es un postre. Cada plato pasa a ser un punto con coordenadas, y los platos parecidos quedan cerca.
Un embedding hace lo mismo con el significado: cada palabra, frase o documento recibe un punto en un espacio con muchas dimensiones. Un espacio real no tiene dos ejes con nombre, sino cientos o miles (las cifras, en la sección de dimensiones). Y casi nunca puedes leer una dimensión como «postreidad»: las aprende el modelo a partir de los datos.
En español verás también «incrustaciones», el término que usa IBM. El curso de Google en español usa sobre todo «embeddings». Es el mismo concepto.
Embeddings frente a palabras clave: la diferencia que importa
Una búsqueda que solo compara palabras mira si las de tu consulta aparecen en el documento. Un embedding mira si significan algo parecido. Esa es la diferencia práctica:
| Coincidencia de palabras | Comparación con embeddings | |
|---|---|---|
| Qué compara | Las cadenas de texto | Los vectores que calcula un modelo |
| Qué detecta | Que aparezca la misma palabra | Que el significado sea cercano, aunque las palabras sean otras |
| Ejemplo | Un sistema que solo compara cadenas no relaciona «zapatillas» con «calzado para correr» | Las dos consultas quedan cerca en el espacio |
| Punto débil | Se pierde lo que se dice con otras palabras | Depende del modelo y de los datos con los que aprendió |
Hay otra forma de ver el problema, la que cuenta Google. Si representas cada plato de un menú de 5.000 con una codificación one-hot (un vector de 5.000 posiciones con un solo 1), cada vector es enorme, casi todo ceros. Google enumera, entre otras pegas, muchos pesos que entrenar, más datos, más procesamiento y más memoria. Un embedding resuelve eso con una representación de menos dimensiones, que además coloca cerca lo parecido. Google resume los embeddings como representaciones de menos dimensiones de datos dispersos: el one-hot es disperso; el embedding, denso.
Cómo funciona un embedding: del texto al vector
Le das un texto a un modelo de embeddings y te devuelve un vector, una lista de números decimales. Por ejemplo, según la documentación de OpenAI, el modelo text-embedding-3-small devuelve un vector de cientos o miles de números para cada texto.
La distancia entre dos vectores mide lo relacionados que están. Según OpenAI, una distancia pequeña indica mucha relación y una grande, poca. Esa distancia se puede calcular de varias maneras, como la euclidiana o el coseno, según IBM. OpenAI recomienda la similitud del coseno y añade que la elección de la función «normalmente no importa mucho»: sus embeddings están normalizados a longitud 1, así que el coseno y la distancia euclidiana dan el mismo orden de resultados.
¿Y por qué «parecido» quiere decir «cercano»? Porque el modelo aprende de ejemplos. Google lo ilustra con dos frases, «anduvieron en burro por el Gran Cañón» y «anduvieron a caballo por el cañón»: como «caballo» y «burro» aparecen en contextos parecidos, el modelo los trata como palabras relacionadas, y en un espacio de embedding las palabras que aparecen en contextos similares quedan más cerca.
Un ejemplo con números
Para ver la cuenta, usa un ejemplo inventado con solo dos dimensiones (un modelo real tiene cientos o miles). Supón estos vectores:
- «zapatillas para correr»: (0,9; 0,4)
- «calzado running»: (0,8; 0,5)
- «ofertas de hipoteca»: (0,1; 0,9)
La similitud del coseno entre las dos primeras sale en 0,99 y entre la primera y la tercera en 0,50. Cuanto más cerca de 1, más parecidas. El modelo no sabe de zapatillas: solo ha colocado cerca lo que aparece en contextos parecidos.
Cómo se crean los embeddings
El curso de Google describe dos técnicas. La primera son las técnicas de reducción de dimensiones, que condensan un espacio de muchas dimensiones en uno de pocas; el análisis de componentes principales (ACP) se usa, por ejemplo, para crear embeddings de palabras. La segunda es entrenarlos dentro de una red neuronal, donde una capa oculta hace de capa de embedding: da un embedding a medida de tu tarea, pero puede tardar más que entrenarlo por separado.
En la práctica también puedes usar embeddings ya entrenados, como los vectores de word2vec; IBM cuenta que Google desarrolló Word2Vec en 2013, y cita entre los modelos más conocidos Word2Vec, GloVe, FastText y las incrustaciones derivadas de transformadores como BERT y GPT. Para trabajo de contenidos, lo habitual es usar un modelo ya entrenado a través de una API, por ejemplo la de OpenAI.
Tipos de embeddings
Puedes clasificarlos por lo que representan y por cómo tratan el contexto.
| Criterio | Tipo | Qué es | Dónde lo verás |
|---|---|---|---|
| Qué representan | Palabras y texto | Un vector por palabra, frase o documento | Búsqueda semántica, agrupar keywords |
| Imágenes | Un vector por imagen | Buscar imágenes parecidas | |
| Audio y grafos | Vectores de sonidos o de nodos de una red | Reconocimiento de voz (audio); recomendaciones y detección de fraude (grafos) | |
| Contexto | Estáticos | Un único vector por palabra (word2vec) | Modelos clásicos de palabras |
| Contextuales | Un vector distinto según las palabras que rodean | Modelos de lenguaje actuales |
Según IBM, se pueden representar como embeddings palabras, textos, imágenes, audio y grafos. El ejemplo de Google para el contexto es «naranja»: con un embedding estático siempre queda más cerca de otros colores que de «jugo»; con uno contextual cada frase obtiene su propio vector, así que la fruta y el color se separan.
¿Cuántas dimensiones tiene un embedding?
Depende del modelo. Como orden de magnitud, Google da 256, 512 o 1.024 para embeddings de palabras, IBM indica que pueden llegar a mil o más y OpenAI da por defecto 1.536 (text-embedding-3-small) o 3.072 (text-embedding-3-large). Más dimensiones no significan «mejor» por sí solas: OpenAI permite acortar el vector con un parámetro, sin perder las propiedades que representan el concepto, aunque a cambio de algo de precisión, según OpenAI.
¿Usan embeddings ChatGPT, los LLM y la IA generativa?
Sí, aunque ni OpenAI ni Google detallan en su documentación cómo los usan ChatGPT o la Búsqueda. IBM explica que la implementación de embeddings de OpenAI permite que ChatGPT entienda las relaciones entre palabras y categorías en lugar de analizar cada palabra por separado. El curso de Google sobre LLM añade que las arquitecturas que solo incluyen un codificador convierten el texto de entrada en una representación intermedia, a menudo una capa de embedding.
- OpenAI. Su guía de embeddings no menciona ChatGPT: documenta los embeddings como modelos que puedes usar desde su API.
- Google Búsqueda. Su guía de funciones de IA no menciona los embeddings (lo comprobamos en el texto de la página), así que lo que hacen sus sistemas por dentro no se puede afirmar desde ahí.
En la IA generativa, un uso habitual es el RAG: el sistema puede buscar por similitud los fragmentos más cercanos a la pregunta y se los da al modelo antes de responder.
La conclusión práctica: no hay una lista pública de dónde usa embeddings cada producto. Si lees que «Google ordena con embeddings» o «ChatGPT elige tu página por su vector», pide la fuente primaria.
Para qué sirven los embeddings
OpenAI enumera los usos más comunes de sus embeddings de texto: búsqueda (ordenar resultados por relevancia a una consulta), agrupación de textos por similitud, recomendaciones, detección de anomalías, medición de diversidad y clasificación.
El caso más conocido es la búsqueda semántica. Conviertes en vectores la consulta y cada documento, calculas la similitud del coseno entre la consulta y cada uno, y devuelves los que más puntúan. Esos vectores se pueden guardar en una base de datos vectorial, que OpenAI recomienda para buscar rápido entre muchos vectores. Por eso encuentras resultados que no repiten tu palabra exacta pero tratan lo mismo.
Los embeddings son además una pieza de otras técnicas que ya tienen su propia entrada del glosario. En el RAG, por ejemplo, el modelo recupera fuentes antes de responder, y esa recuperación puede apoyarse en este tipo de búsqueda por similitud.
Cómo se usan los embeddings en SEO y en marketing
Cuatro de los usos que enumera OpenAI (búsqueda, agrupación, recomendación y clasificación) se pueden aplicar al trabajo de contenidos. No describen cómo posiciona Google por dentro, sino lo que puedes hacer tú con ellos:
| Uso | Qué haces | Qué tienes que revisar a mano |
|---|---|---|
| Agrupar keywords por significado | Calculas el vector de cada consulta y las agrupas por cercanía | Que cada grupo comparta intención de búsqueda, mirando la SERP |
| Encontrar contenidos parecidos | Comparas los vectores de tus páginas | Si hay canibalización de verdad: mira intención y datos de Search Console |
| Proponer enlaces internos | Para una página, listas las más cercanas en significado | Que el enlace tenga sentido para el lector, no solo para la cifra |
| Clasificar consultas o páginas | Etiquetas por tema o intención a partir de ejemplos ya etiquetados | Una muestra de las etiquetas, antes de fiarte del resto |
| Detectar huecos | Buscas temas de tu sector sin página cercana | Que el hueco sea demanda real y no un tema que no te interesa |
Un flujo para agrupar keywords
- Reúne las consultas: por ejemplo, las de Search Console de una carpeta de tu web.
- Calcula el vector de cada una con el mismo modelo para todas.
- Agrúpalas. OpenAI muestra un ejemplo con el algoritmo K-means sobre 1.000 reseñas, con cuatro grupos.
- Revisa cada grupo: ¿piden lo mismo? Si no, sepáralo.
- Decide la página de cada grupo con la intención que ves en la SERP.
Si la lista incluye datos de un cliente, comprueba antes dónde se procesan: una API externa recibe esos textos.
Cómo lo usamos en BIGSEO
Para el enlazado interno aplicamos embeddings multilingües a un crawl de la web y buscamos pares de páginas muy parecidas que todavía no se enlazan entre sí. Empezamos con un umbral de similitud de 0,6 y lo ajustamos entre 0,55 y 0,7 según lo que veamos en los diez primeros pares. Priorizamos combinando la similitud con el tráfico de Search Console de la página de origen. Y antes de insertar cada enlace lo revisa una persona, porque el embedding no distingue canibalización de oportunidad.
¿Hay que optimizar tu contenido «para embeddings»?
No hay un truco que Google documente. Su guía sobre las funciones de IA en la Búsqueda (2025-12-31) dice que no hay requisitos adicionales para aparecer en las vistas creadas con IA ni en el modo IA, ni optimizaciones especiales, y esa guía no menciona los embeddings. Su guía de optimización para la IA generativa añade que muchos de los «trucos» de AEO o GEO que circulan no son eficaces y que optimizar para la búsqueda con IA generativa sigue siendo SEO, y que la guía de julio de 2026 añade que el sitio debe estar incluido en las funciones de IA generativa de la Búsqueda en Search Console, algo que desde el 31 de agosto de 2026 es la opción predeterminada.
Lo que sí te dice el concepto es algo sobre el modelo, no sobre Google: un modelo de embeddings representa el contexto en el que se usa cada palabra, no un recuento de repeticiones, así que una página que explica bien un tema con las palabras que usa la gente puede quedar cerca de las consultas relacionadas sin repetir la keyword exacta. Sobre Google, su guía de optimización para la IA generativa dice que sus sistemas de IA entienden la relevancia de una página incluso sin concordancia exacta entre la consulta y el contenido. Por eso en BIGSEO lo tratamos como parte del SEO en LLMs, no como una disciplina aparte. Más contexto en nuestra guía de SEO para IA.
Errores comunes al hablar de embeddings
- Creer que cuentan palabras. Un embedding recoge el contexto en el que se usa cada palabra, como «burro» y «caballo», que quedan cerca porque aparecen en contextos parecidos; no es un recuento de apariciones.
- Comparar vectores de modelos distintos. Google indica que los embeddings difieren según la tarea para la que se entrenan, y es razonable deducir que lo mismo pasa entre modelos distintos: compara siempre vectores calculados con el mismo modelo.
- Leer una similitud alta como «Google lo posicionará». Esa cifra es de un modelo concreto, no de Google.
- Dar por buenas las agrupaciones sin revisarlas. Una agrupación automática es un punto de partida: una persona tiene que comprobar que cada grupo comparte intención.
- Olvidar que el modelo tiene fecha. OpenAI avisa de que sus modelos
text-embedding-3no conocen eventos posteriores a septiembre de 2021; puede afectar a temas de actualidad. - Pensar que más dimensiones es siempre mejor. Depende del modelo y de la tarea, y OpenAI permite acortar el vector.
Preguntas frecuentes
¿Qué es un embedding en inteligencia artificial?
Es la lista de números con la que un modelo de IA representa un texto, una imagen o un audio, de modo que lo que significa algo parecido queda cerca. Es la forma de que una máquina compare significados sin depender de palabras idénticas.
¿Qué son los embeddings en español?
Son las «incrustaciones» (el término de IBM): vectores que representan el significado de un contenido. En el sector se suele usar la palabra inglesa.
¿Qué tipos de embeddings hay?
Por lo que representan: palabras, textos, imágenes, audio y grafos. Por el contexto: estáticos (un vector por palabra) y contextuales (un vector distinto según la frase).
¿Qué es la similitud del coseno?
Es una forma de medir lo parecidos que son dos vectores por el ángulo entre ellos: cuanto más cerca de 1, más parecidos. OpenAI la recomienda y, como sus embeddings están normalizados, ordena los resultados igual que la distancia euclidiana.
¿Qué es una base de datos vectorial?
Es una base de datos pensada para guardar vectores y encontrar rápido los más cercanos a uno dado. OpenAI la recomienda cuando hay que buscar entre muchos embeddings.
¿Qué diferencia hay entre embeddings y palabras clave?
Una palabra clave es una cadena de texto que se busca tal cual. Un embedding es un vector que representa el significado, así que dos textos con palabras distintas pueden quedar cerca. Se usan como herramienta de trabajo, no como objetivo de optimización.
Términos relacionados
Fuentes
- Embeddings: espacio de embedding y embeddings estáticos (Google for Developers, Machine Learning Crash Course), consultado el 2026-10-19.
- Embeddings (Google for Developers, Machine Learning Crash Course), consultado el 2026-10-20.
- Cómo obtener embeddings (Google for Developers, Machine Learning Crash Course), consultado el 2026-10-20.
- LLM: ¿Cuál es un modelo grande de lenguaje? (Google for Developers, Machine Learning Crash Course), consultado el 2026-10-20.
- Vector embeddings (documentación de la API de OpenAI), consultado el 2026-10-20.
- ¿Qué es la incrustación? (IBM), consultado el 2026-10-20.
- Funciones de IA y tu sitio web (Google Search Central), consultado el 2026-10-19.
- Guía de Google sobre la optimización para las funciones de IA generativa de la Búsqueda (Google Search Central), consultado el 2026-10-19.
Por dónde seguir
¿Quieres aplicar la IA en tu empresa con criterio? Te ayudamos con nuestro equipo de IA para empresas. ¡Hablemos de generar negocio!