El RAG (Retrieval-Augmented Generation, o generación aumentada por recuperación) es una técnica de IA en la que un modelo de lenguaje busca primero información en fuentes externas (páginas web, documentos o bases de datos) y genera la respuesta apoyándose en lo recuperado, en vez de depender solo de lo que aprendió al entrenarse.
Piénsalo como un examen a libro abierto: el modelo no contesta de memoria, abre primero los apuntes que le pasan y responde con ellos delante.
Qué quiere decir RAG y de dónde viene el término
RAG significa Retrieval-Augmented Generation (en castellano, generación aumentada por recuperación): «recuperación» es la búsqueda de información relevante y «generación» es la redacción de la respuesta por parte del modelo de lenguaje (LLM). A veces se usa también para nombrar el sistema completo: cuando alguien habla de «un RAG», suele referirse a la aplicación entera (la base de documentos, el buscador y el modelo que responde).
El término procede de un artículo científico de 2020, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, de Patrick Lewis y otros 11 autores, aceptado en NeurIPS 2020. Allí se describen modelos que combinan la memoria del modelo preentrenado con una memoria externa: un índice vectorial de Wikipedia consultado con un recuperador neuronal. Según sus autores, estos modelos generaron un lenguaje más específico, diverso y factual que un modelo que solo usa su memoria interna. El propio artículo señala que dar la procedencia de las decisiones del modelo y actualizar su conocimiento eran problemas de investigación todavía abiertos.
Por eso el RAG no es un modelo distinto ni sustituye al LLM: es una forma de usarlo, dándole documentos relevantes antes de que responda.
Cómo funciona RAG: del documento a la respuesta
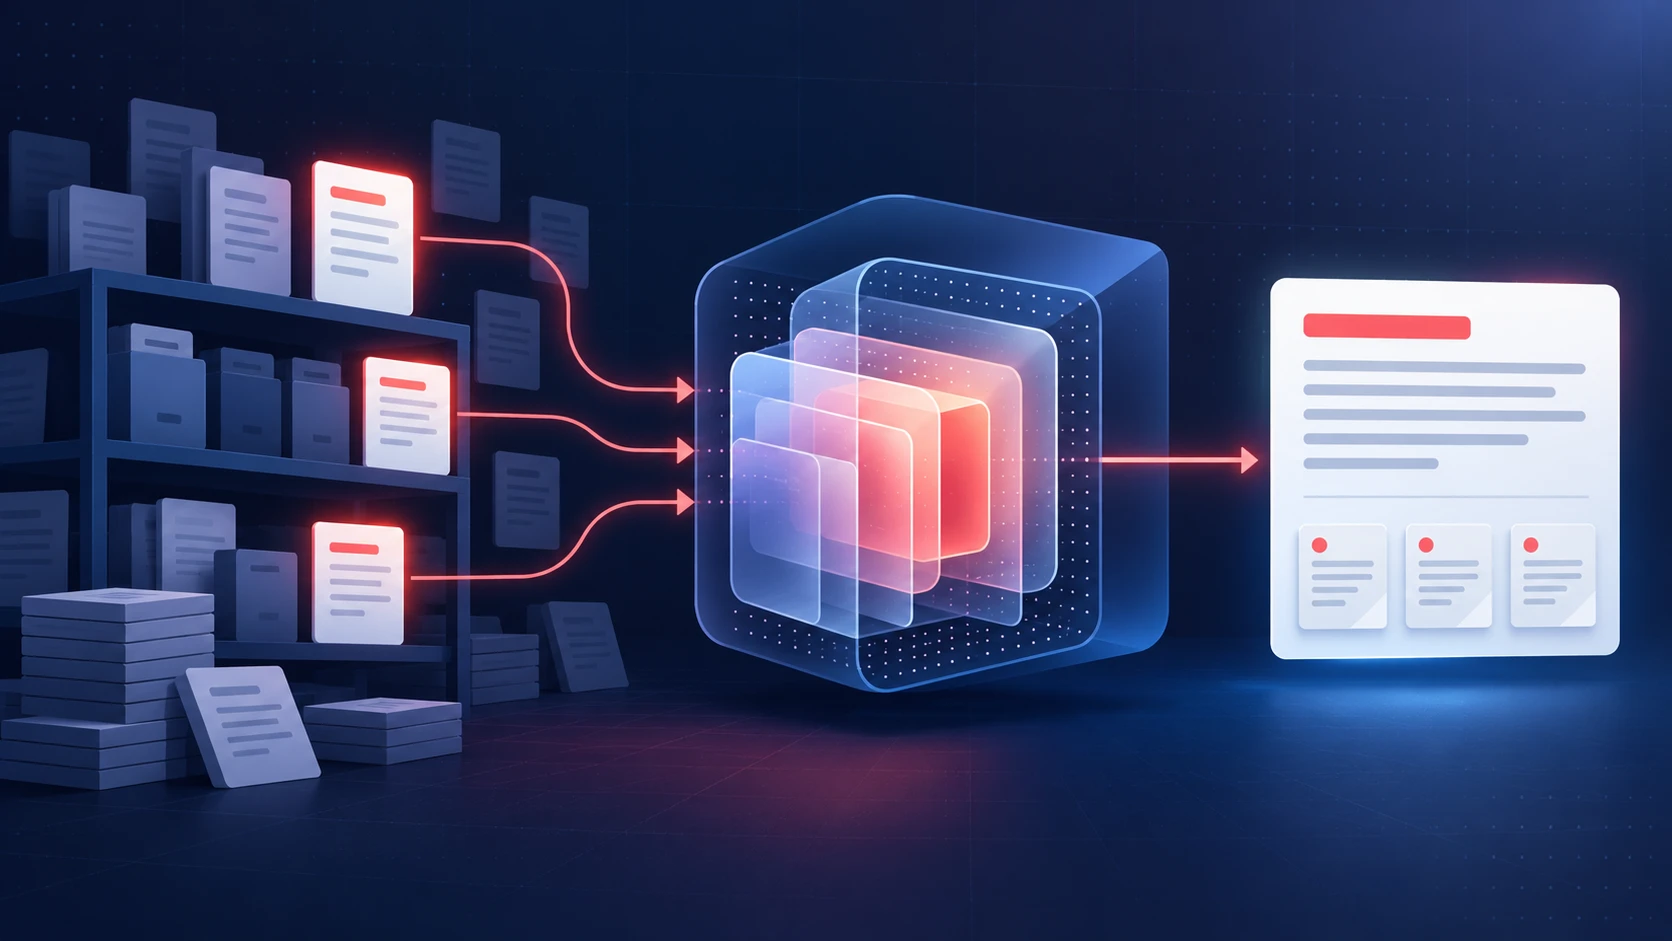
RAG funciona en cuatro pasos: preparar los documentos, indexarlos, recuperar los relevantes cuando llega una pregunta y generar la respuesta con ellos. Es el esquema de pipeline que describe Databricks (IBM lo cuenta desde el punto de vista de la consulta, en cinco etapas, con el mismo fondo):
- Preparar y fragmentar los documentos: se reúnen los textos (con sus metadatos) y se dividen en fragmentos de un tamaño adecuado. Según IBM, si el fragmento es demasiado grande se vuelve demasiado general y, si es demasiado pequeño, pierde coherencia.
- Indexar: cada fragmento se convierte en un vector (un embedding), una representación numérica de su significado, y se guarda en una base de datos vectorial.
- Recuperar: la pregunta del usuario se convierte también en un vector y se buscan los fragmentos más parecidos en significado, no solo en palabras exactas.
- Aumentar el prompt y generar: los fragmentos recuperados se añaden a la pregunta y el LLM redacta la respuesta con ese contexto.
Una base de datos vectorial es el almacén donde viven esos embeddings: permite encontrar fragmentos por similitud de significado, aunque no compartan las palabras exactas de la pregunta. Es una pieza del RAG, no el RAG entero. Google Cloud añade que los buscadores más avanzados combinan búsqueda semántica y por palabras clave (búsqueda híbrida) y usan un reclasificador que puntúa los resultados para que los primeros sean los más relevantes. AWS añade un paso que se suele olvidar: mantener los datos al día, actualizando los documentos y sus embeddings de forma automática o por lotes.
Un ejemplo con prompt aumentado
Un asistente de una tienda online recibe la pregunta «¿cuánto tarda una devolución?». En vez de inventar un plazo, recupera el párrafo de la página de devoluciones y se lo pasa al modelo junto con la pregunta. Lo que recibe el LLM sería algo así (texto y plazo ficticios, solo para ilustrar):
Pregunta del usuario: ¿Cuánto tarda una devolución?

Contexto recuperado (página «Devoluciones»):
«Tienes 30 días desde la entrega para solicitar la devolución. Cuando
recibimos el paquete, reembolsamos el importe en un máximo de 7 días.»

Instrucción: responde solo con el contexto recuperado y cita la página.
Si el contexto no contiene la respuesta, dilo.

Respuesta generada: Tienes 30 días desde la entrega para pedirla y el
reembolso llega en un máximo de 7 días tras recibir el paquete
(fuente: página «Devoluciones»).
La respuesta ya no depende de lo que el modelo recuerde, sino de lo que pone la página. Y si el cliente cambia su política, basta con actualizar esa página y reindexarla; no hay que tocar el modelo.
Componentes de un sistema RAG
Un sistema RAG tiene cuatro piezas principales: base de conocimientos, recuperador, capa de integración y generador (IBM).
| Componente | Qué hace |
|---|---|
| Base de conocimientos | Repositorio de datos externo (PDF, documentos, guías, sitios web…) convertido en vectores; debe actualizarse de forma continua. |
| Recuperador | Transforma la consulta en un embedding y busca los más parecidos en la base. Si recupera mal, la respuesta falla aunque el modelo sea bueno. |
| Capa de integración | Coordina el sistema y construye la instrucción aumentada, a menudo con marcos de orquestación como LangChain o LlamaIndex. |
| Generador | El LLM (por ejemplo GPT, Claude o Llama) que redacta la respuesta a partir de la pregunta y los datos recuperados. |
Los sistemas más avanzados añaden un clasificador que ordena lo recuperado por relevancia y un controlador que da formato a la respuesta.
Para qué sirve RAG: usos y ejemplos
- Información actualizada: un LLM se limita a sus datos de entrenamiento y puede dar respuestas obsoletas; con RAG se le puede dar información reciente.
- Menos invenciones: darle datos al modelo como parte de la petición puede mitigar las alucinaciones (Google Cloud).
- Respuestas con fuente: el modelo puede mostrar citas o referencias y el usuario consultar los documentos de origen (AWS).
- Sin reentrenar: una vía más rentable que volver a entrenar el modelo para introducir datos propios (AWS).
- Control de acceso y privacidad: el Instituto de Ingeniería del Conocimiento (IIC, UAM) apunta que un RAG permite acceso granular a la información (no todos los usuarios ven todos los documentos) y mantener los documentos privados en servidores propios.
Los casos de uso más habituales, según IBM, Databricks y el IIC, son chatbots y asistentes especializados de atención al cliente, motores de conocimiento interno (por ejemplo, preguntas de RR. HH. o de cumplimiento normativo), búsqueda aumentada con respuestas generadas, investigación sobre documentación legal o médica y servicios de recomendación.
Aplicado a marketing y contenidos, encaja por ejemplo en:
- Atención y ventas: un asistente en tu web que responde solo con tus fichas de producto, tus condiciones y tu FAQ.
- Equipos de contenido: un buscador interno sobre briefings, guías de estilo y casos publicados, para que el redactor consulte la fuente en vez de preguntarle al modelo «de memoria».
Es una de las piezas con las que la IA generativa se conecta a datos que no tenía al entrenarse, y también la base de muchos agentes de IA que necesitan consultar información de la empresa.
RAG frente a fine-tuning y otras opciones
Databricks plantea cuatro maneras de adaptar un LLM a los datos de una organización, que no son excluyentes y pueden combinarse:
| Método | Qué es | Cuándo encaja | Contrapartida |
|---|---|---|---|
| Ingeniería de prompts | Instrucciones especializadas para guiar al modelo. | Guiar al modelo de forma rápida, sin datos adicionales. | Menos control que el ajuste fino. |
| RAG | Combinar el LLM con recuperación de conocimiento externo. | Datos dinámicos y conocimiento externo. | Alarga el prompt y aumenta el cálculo de inferencia. |
| Fine-tuning (ajuste fino) | Adaptar un modelo preentrenado a un dominio o tarea. | Especializar el modelo o cambiar su comportamiento. | Exige datos etiquetados y coste de cómputo. |
| Preentrenamiento | Entrenar un LLM desde cero. | Tareas muy singulares o corpus de dominio propio. | Requiere conjuntos de datos enormes. |
La diferencia en una frase, según IBM: el RAG permite al modelo consultar una fuente externa, mientras que el ajuste fino lo entrena con datos de un dominio. Databricks recomienda empezar por RAG, porque es sencillo y puede bastar, y reservar el ajuste fino para cambiar el comportamiento del modelo; ambos se pueden usar a la vez.
RAG y búsqueda semántica no son lo mismo: según AWS, la búsqueda semántica mejora los resultados del RAG cuando hay muchas fuentes y mucha información dispersa, porque recupera con más precisión el pasaje adecuado. La búsqueda es una pieza del RAG; el RAG es el sistema completo que además genera la respuesta.
Tipos de RAG
Salesforce distingue varios enfoques relacionados: el RAG basado en vectores (el que recupera fragmentos por similitud de embeddings), los grafos de conocimiento, que organizan los datos en nodos y relaciones, y el RAG de conjunto, que ejecuta más de un recuperador a la vez y combina los resultados para que uno compense las debilidades de otro.
Límites y errores comunes con el RAG
- Confundirlo con entrenar o ajustar el modelo: el RAG no cambia el modelo, le da documentos en el momento de responder.
- Creer que elimina las alucinaciones: Google Cloud advierte de que, si la información recuperada es irrelevante, la respuesta puede ser correcta pero no tener nada que ver con la pregunta, o ser incorrecta. La recuperación es la pieza decisiva.
- Descuidar la calidad de la recuperación y del fragmentado: Databricks cita entre los desafíos habituales la calidad de la recuperación, las limitaciones de la ventana de contexto (meter demasiado contenido diluye la respuesta) y las estrategias de fragmentación, que deben equilibrar coherencia semántica y eficiencia.
- No actualizar el índice: Databricks avisa de que los índices de documentos pueden quedarse obsoletos enseguida sin ingestas programadas o actualizaciones automáticas.
- Olvidar la latencia y la evaluación: según Databricks, evaluar un RAG exige combinar criterio humano, puntuación de relevancia y comprobaciones de fundamentación (que la respuesta se apoye de verdad en lo recuperado).
Cómo se crea un RAG
Se montan los cuatro pasos (preparar e indexar los documentos, recuperar y generar) con una capa de orquestación y se mide si las respuestas se apoyan en lo recuperado. Google Cloud menciona métricas como la fundamentación o la calidad de la respuesta a preguntas. Empieza con pocos documentos fiables y una lista de preguntas reales: si la recuperación falla ahí, no lo arreglará un modelo más grande.
Por qué importa el RAG para el SEO en LLMs
Google explica que sus funciones de IA pueden usar una técnica de «distribución múltiple de consultas» (el query fan-out): envían varias búsquedas relacionadas por subtemas y fuentes de datos para construir la respuesta, y muestran enlaces a sitios web de referencia. Google no lo llama RAG. En nuestra lectura (no una afirmación de Google sobre cómo funcionan sus sistemas ni los de otros asistentes), el esquema se parece: primero se buscan páginas y después se redacta con ellas.
Según la página de funciones de IA de Google (2025-12-31), no hay requisitos adicionales para aparecer en sus funciones de IA, como los AI Overviews o el Modo IA: la página debe estar indexada y poder mostrarse con un fragmento, y no hace falta una optimización especial. Lo que recomienda son las prácticas de siempre. La guía de julio de 2026 añade que el sitio debe estar incluido en las funciones de IA generativa de la Búsqueda en Search Console, algo que desde el 31 de agosto de 2026 es la opción predeterminada. De ahí, y de lo que hemos visto sobre cómo se recupera, se sigue una lista de comprobación para tu web:
- Rastreo permitido en robots.txt y en cualquier CDN o infraestructura de alojamiento.
- Contenido importante en texto, accesible para quien lo recupera y no escondido en imágenes.
- Páginas fáciles de encontrar con enlaces internos y con una buena experiencia de página.
- Datos estructurados que coincidan con el texto visible, sin esperar que el marcado sea imprescindible: Google dice que no hace falta schema especial.
- Sin atajos «para IA»: Google indica que no es necesario crear archivos legibles por máquinas ni archivos de texto de IA para aparecer en estas funciones.
- Pasajes que se entiendan solos: Google Cloud indica que la calidad de las respuestas de un sistema RAG puede mejorarse ajustando el análisis o la segmentación de la fuente. Nuestra conclusión es que un párrafo que responde a una pregunta sin necesitar el resto de la página es más fácil de aprovechar.
Si no quieres que se muestre cierto contenido, Google documenta los controles nosnippet, data-nosnippet, max-snippet y noindex. Para medir el rendimiento en las funciones de IA generativa de la Búsqueda y Discover, la guía de Google de julio de 2026 recomienda el informe «Rendimiento» de la IA generativa de Search Console. La documentación anterior de funciones de IA situaba ese tráfico en el informe de rendimiento, en el tipo de búsqueda «Web».
En BIGSEO lo trabajamos como parte del SEO en LLMs, no como una disciplina aparte: no existe un «SEO para RAG» con trucos propios. Se mide con citas, tráfico real y leads, no solo con apariciones. Más contexto en nuestra guía de SEO para IA.
Preguntas frecuentes sobre RAG
¿Qué es RAG y para qué sirve?
Es la técnica que hace que un LLM busque en fuentes externas antes de responder; sirve para dar respuestas actualizadas, con datos propios y con la fuente a la vista.
¿Qué es un RAG en inglés?
Retrieval-Augmented Generation. En castellano se ve también como «generación aumentada de recuperación» o «mejorada por recuperación».
¿Qué es LLM y RAG?
Un LLM es un modelo de lenguaje de gran tamaño entrenado con enormes volúmenes de texto (GPT, Claude o Llama, por ejemplo). El RAG no es otro modelo: es la técnica que le da documentos externos antes de responder.
¿El RAG elimina las alucinaciones?
No: las reduce, pero con documentos irrelevantes u obsoletos la respuesta puede fallar igualmente.
Términos relacionados
- Embeddings: la representación numérica con la que se buscan los documentos por significado.
- IA generativa: la familia de modelos que redactan las respuestas.
- Agente de IA: sistemas que pueden apoyarse en RAG para consultar información de la empresa.
- Modo IA de Google: la búsqueda conversacional de Google, que también muestra enlaces a sus fuentes.
- llms.txt: el archivo de texto pensado para que los modelos lean tu web, otra forma de dar contexto a la IA.
- Query fan-out: la ramificación de una pregunta en varias búsquedas.
- AI Overviews: los resúmenes con IA de Google, que muestran enlaces a sus fuentes.
Fuentes
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis et al., arXiv:2005.11401, NeurIPS 2020), consultado el 2026-10-20.
- ¿Qué es la generación aumentada de recuperación (RAG)? (Google Cloud), consultado el 2026-10-20.
- ¿Qué es RAG?: explicación de la IA de generación aumentada por recuperación, AWS, consultado el 2026-10-20.
- ¿Qué es el RAG (generación aumentada por recuperación)? (IBM), consultado el 2026-10-20.
- ¿Qué es la generación aumentada por recuperación (RAG)? (Databricks), consultado el 2026-10-20.
- ¿Qué es la RAG (generación aumentada de recuperación)? (Salesforce), consultado el 2026-10-20.
- ¿Qué son los sistemas de RAG? (Instituto de Ingeniería del Conocimiento, UAM), consultado el 2026-10-20.
- Funciones de IA y tu sitio web (Google Search Central), consultado el 2026-10-20.
Por dónde seguir
¿Quieres aplicar la IA en tu empresa con criterio? Te ayudamos con nuestro equipo de inteligencia artificial para empresas. ¡Hablemos de generar negocio!