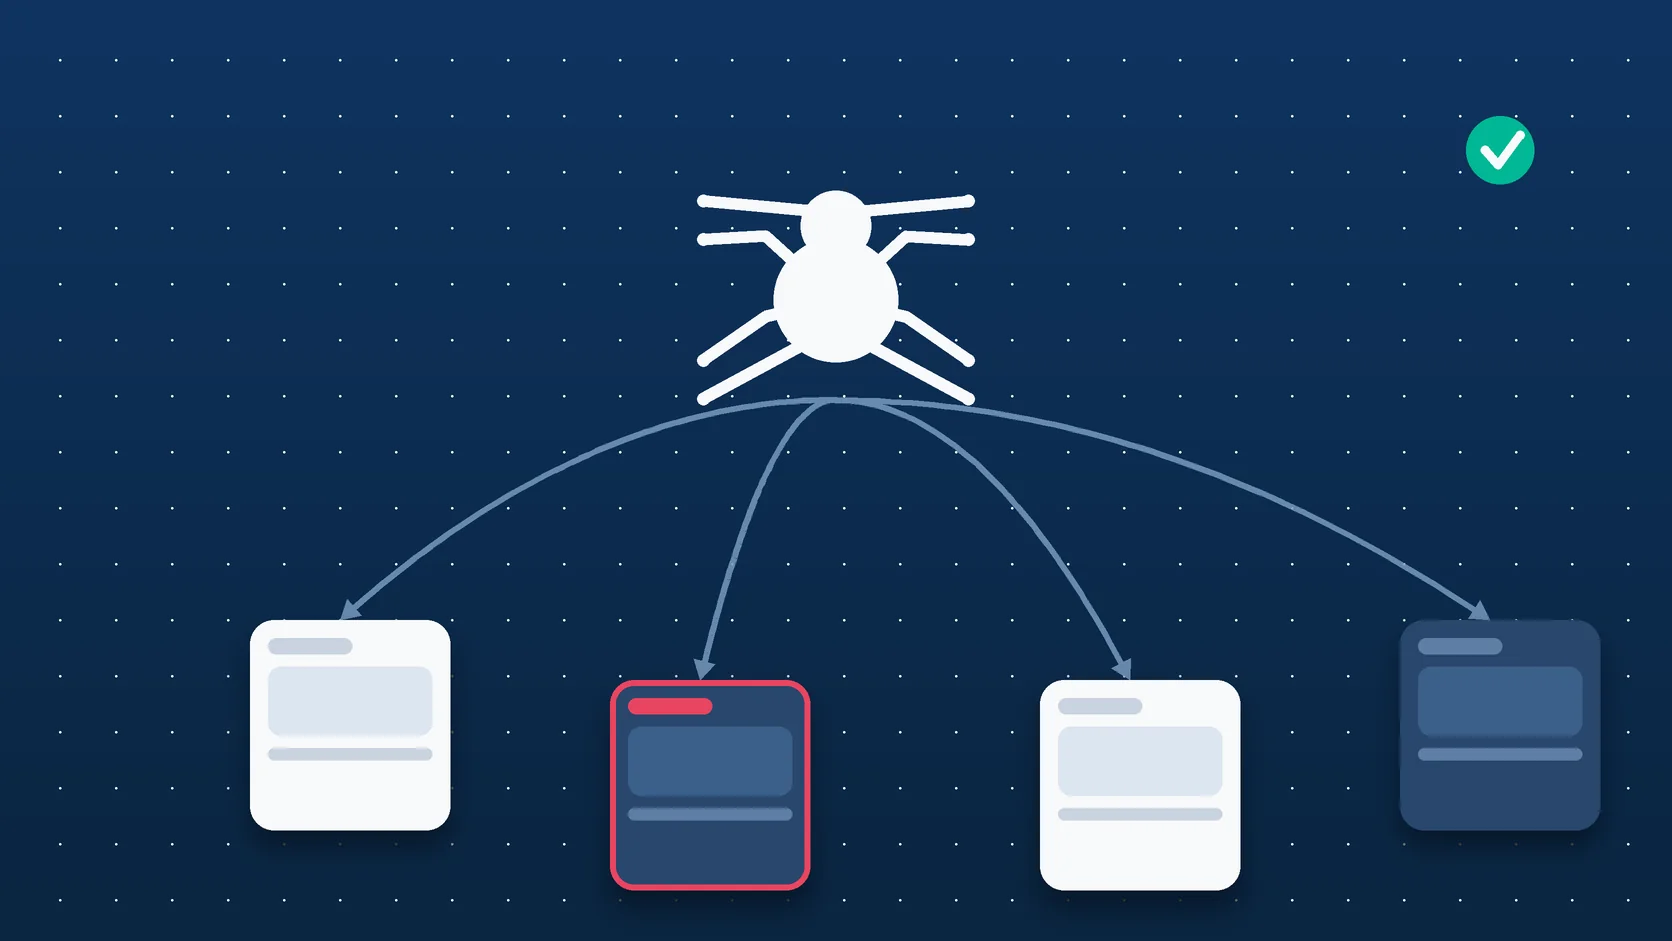
Googlebot es el nombre con el que se identifica el rastreador de la Búsqueda de Google: el programa que visita páginas, sigue enlaces y descarga su contenido para que Google pueda indexarlas. La documentación de Google en español lo llama «robot de Google». Rastrear no es indexar: la decisión de mostrar una página en los resultados es posterior.
| Si lees… | Significa |
|---|---|
| Googlebot o robot de Google | El rastreador de la Búsqueda de Google (esta entrada) |
| Googlebot Smartphone y Googlebot Desktop | Los dos tipos de rastreador que agrupa el nombre |
| Otros rastreadores de Google | Clientes de la misma infraestructura con otro nombre, como los de Shopping o AdSense |
Cómo funciona
Según Google, «robot de Google» es el nombre genérico de dos tipos de rastreadores web: uno para smartphones, que simula a un usuario en un móvil, y otro para ordenadores. Puedes saber cuál te ha visitado en el encabezado HTTP user-agent. Los dos obedecen las reglas del mismo token de robots.txt, así que no puedes elegir uno solo en ese archivo. En la mayoría de los sitios la Búsqueda indexa sobre todo la versión móvil, de modo que la mayor parte de las solicitudes llega del rastreador móvil.
Googlebot descubre URL nuevas principalmente a través de enlaces de páginas que ya ha rastreado. De media, no suele acceder a la mayoría de los sitios más de una vez cada pocos segundos. Si tu servidor tiene problemas para aguantar las solicitudes, puedes reducir la frecuencia de rastreo.
El nombre induce a error. En una entrada de su blog (2026-03-31), Google explica que hoy Googlebot es un cliente de una plataforma de rastreo centralizada: otros productos, como Shopping o AdSense, usan la misma infraestructura con nombres de rastreador distintos. Cuando ves Googlebot en tus registros, ves la actividad de la Búsqueda de Google.
Hay un límite de tamaño que conviene conocer:
| Qué | Límite que indica Google |
|---|---|
| Tipos de archivo compatibles, excepto PDF | Primeros 2 MB por URL |
| Primeros 64 MB | |
| Otros rastreadores sin límite propio | 15 MB |
Al llegar al límite, Googlebot detiene la descarga y envía a indexación lo ya descargado como si fuera el archivo completo; lo que queda después no se descarga, ni se renderiza, ni se indexa. En su blog, Google precisa que el límite de 2 MB incluye los encabezados HTTP de la respuesta y que cada recurso del HTML (CSS, JavaScript) se descarga aparte, con su propio contador. Después, el servicio de renderizado ejecuta el código que se haya descargado, de forma parecida a un navegador moderno, y no solicita imágenes ni vídeos.
Cómo se aplica en SEO
- Enlaza las páginas que te importan. Como Googlebot descubre URL sobre todo por enlaces, una página sin enlaces desde otras páginas rastreadas es más difícil de encontrar.
- Mantén el HTML ligero y coloca arriba lo esencial. Google recomienda mover el CSS y el JavaScript pesado a archivos externos y situar al principio del documento las etiquetas meta, el
title, las canonical y los datos estructurados importantes, para que sea poco probable que queden por debajo del corte. - Elige el control adecuado. Para impedir el rastreo, usa un archivo robots.txt; para que Google no indexe una página, usa
noindex; para que no accedan ni rastreadores ni usuarios, usa otro método como la protección con contraseña. - Comprueba que sea Googlebot antes de bloquearlo. Hay rastreadores que falsifican su
user-agent. Google propone una petición de DNS invertida a la IP de origen y otra de DNS normal sobre el nombre obtenido, o comparar la IP con sus rangos publicados.
Errores comunes
- Pensar que bloquear con robots.txt saca una página de Google. Google lo advierte: bloquear el rastreo no impide que la URL aparezca en los resultados. Para que no se indexe, hace falta
noindex, y la página no debe estar bloqueada para que Googlebot pueda ver esa regla. - Fiarse del
user-agentsin verificar. Un registro que dice «Googlebot» puede no serlo. La comprobación de Google usa el DNS invertido o los rangos de IP. - Creer que existe un único Googlebot. Son dos tipos de rastreador con las mismas reglas de robots.txt, y el nombre cubre la actividad de la Búsqueda dentro de una infraestructura que usan otros productos de Google.
- Dejar el contenido importante al final de un HTML enorme. Si queda por detrás de los 2 MB, Googlebot lo ignora. Google cita como causas posibles las imágenes en base64 incrustadas o los bloques grandes de CSS y JavaScript en línea.
Amplía en
Para profundizar en cómo se reparte el rastreo, tienes nuestro post sobre el crawl budget y el de robots.txt.
Términos relacionados
Fuentes
- Qué es el robot de Google (Google Search Central), última actualización 2026-02-06, consultado el 2026-11-12.
- Información general sobre los rastreadores y fetchers de Google (Google Search Central), última actualización 2026-06-17, consultado el 2026-11-12.
- Verificar las solicitudes de los rastreadores y los fetchers de Google (Google Search Central), última actualización 2026-03-25, consultado el 2026-11-12.
- Inside Googlebot: demystifying crawling, fetching, and the bytes we process (Google Search Central Blog), publicada el 2026-03-31 y corregida el 2026-10-29, consultado el 2026-11-12.
Por dónde seguir
¿Quieres saber cómo rastrea Googlebot tu web y qué se le queda sin ver? Te ayudamos con nuestro equipo de agencia SEO. ¡Hablemos de generar negocio!