El contenido duplicado es el mismo contenido accesible desde varias URLs, dentro o fuera de tu web. No hay una penalización por duplicado como tal, pero sí un coste real: Google elige una versión, reparte las señales entre varias y te gasta rastreo. Se resuelve eligiendo tú la versión buena antes de que la elija él.
Qué es el contenido duplicado
Contenido duplicado es un mismo bloque de contenido, o uno muy parecido, accesible desde más de una URL.
La definición parece obvia y sin embargo la mayoría del duplicado que encontramos en auditorías no lo genera nadie a propósito: lo genera la configuración del CMS, el servidor o el sistema de filtros, y lleva años ahí sin que nadie lo mire.
Duplicado interno frente a externo
El interno está dentro de tu dominio: el mismo contenido en varias URLs tuyas. Es el más frecuente, el más dañino y, afortunadamente, el que controlas al cien por cien.
El externo es contenido tuyo que aparece en otros dominios, o contenido de otros que aparece en el tuyo. Aquí entran el scraping, la sindicación de notas de prensa y las descripciones de fabricante que comparten cincuenta tiendas.
El orden de prioridad es claro: arregla primero el interno. Es el que puedes resolver hoy y el que más te está costando.
Sindicación y páginas de campaña
Si otro medio publica tu artículo completo, hay dos versiones del mismo texto y la suya, con más autoridad, puede superarte. Pide que añada una canonical a tu original o que publique solo un extracto con enlace. Y las landings de campaña que solo cambian el titular o la imagen se consolidan con canonical o 301.
Duplicado exacto frente a casi-duplicado
Exacto es carácter por carácter. Fácil de detectar, fácil de decidir.
Casi-duplicado es lo mismo con variaciones menores: la landing de Bilbao y la de Zaragoza cambiando el topónimo, o dos fichas de producto que solo difieren en el color. Es más difícil de detectar y es donde está la mayor parte del problema real.
Cuando el casi-duplicado se hace a escala, deja de ser un problema de duplicado y pasa a ser uno de thin content. Son dos caras de lo mismo.
Y hay una tercera capa que crece con la IA: el duplicado semántico, páginas que dicen lo mismo con otras palabras. No comparten frases, así que los detectores clásicos no lo ven, pero para el usuario y para Google responden a lo mismo.
Los casos que casi nadie cuenta como duplicado y lo son
Aquí es donde se esconde el grueso, y es la sección que ningún resultado de la primera página desarrolla bien.
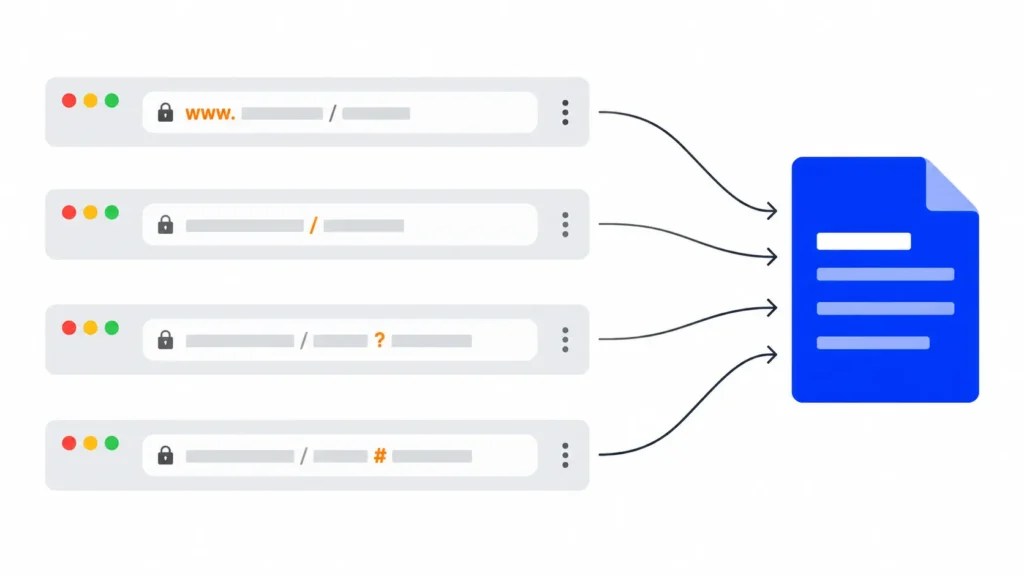
http/https, www, barra final y mayúsculas
Para una persona, estas son la misma página. Para un servidor son cuatro URLs distintas:
http://tudominio.com/paginahttps://tudominio.com/paginahttps://www.tudominio.com/paginahttps://www.tudominio.com/pagina/
Y si tu servidor no distingue mayúsculas, /Pagina también responde. Sumadas las combinaciones, la misma página puede ser accesible desde ocho URLs.
Se arregla con redirecciones a nivel de servidor hacia una única versión canónica. Es la primera comprobación de cualquier auditoría y sigue fallando más a menudo de lo que parece.
Parámetros de campaña y de filtro
?utm_source=newsletter crea una URL nueva a ojos de un rastreador. Igual que ?orden=precio, ?sessionid= o ?ref=.
Los de campaña se resuelven con canonical a la URL limpia. Los de filtro y ordenación, con la política de facetas que expliques en tu arquitectura.
Versiones de impresión, AMP y paginación
Las versiones para imprimir son duplicado puro y hoy no las necesita casi nadie: si existen, noindex o eliminar.
Las páginas AMP con su canonical bien puesta no son un problema: en Search Console aparecen como «Página alternativa con etiqueta canónica adecuada» y no tienes que hacer nada.
En la paginación, el contenido de cabecera de la categoría suele repetirse en las páginas 2, 3 y 4. La solución correcta no es poner canonical de la página 2 a la 1, algo que Google pide expresamente no hacer: es que cada página de paginación tenga su propia canonical y no repita el bloque de texto. Y olvídate de rel=next/prev: Google ya no lo usa.
¿Penaliza el contenido duplicado?
La respuesta corta y el matiz que importa
No existe una penalización por contenido duplicado. Google lo ha repetido durante años y es cierto.
El matiz, que es lo que importa: que no haya penalización no significa que no tenga coste. Lo tiene, y es medible. Solo que el mecanismo no es un castigo, es una consecuencia.
Cuándo deja de ser duplicado y pasa a ser spam
Google lo dice en su documentación de canonicalización: tener algo de contenido duplicado es normal y no infringe sus políticas de spam.
Lo que sí las infringe tiene nombre propio:
- Contenido extraído (scraping): copiar contenido de otras webs y publicarlo sin añadir nada, o cambiarlo apenas con sinónimos o técnicas automáticas.
- Abuso de contenido a escala: generar muchas páginas con el objetivo principal de manipular el ranking y no de ayudar al usuario. Entre los ejemplos de Google está usar IA generativa para crear muchas páginas sin valor añadido.
La frontera no es cuánto se parece un texto a otro. Es la intención y el valor. Una ficha con el texto del fabricante es duplicado. Mil páginas cosidas con contenido ajeno para captar búsquedas es spam, y ahí Google puede bajarte o sacarte de los resultados, con sistemas automáticos o con una acción manual.
Qué pasa de verdad: elección de canónica y dilución
Tres efectos concretos:
Google elige por ti. Cuando encuentra varias URLs con el mismo contenido, elige una para indexar y mostrar. Puede elegir la que tú no querías, y entonces ves impresiones en una URL que no es tu landing.
Las señales se reparten. Los enlaces externos que apuntan a tres versiones de la misma página reparten su fuerza entre las tres. Consolidadas, sumarían.
Se gasta rastreo. Cada versión duplicada es una petición que Googlebot no dedica a otra cosa. En sitios grandes es el efecto más caro, y está desarrollado en la guía de crawl budget.
Cómo detectar el contenido duplicado
Detección interna con un crawler
Es el método principal y el único que da la foto completa. Rastreas tu sitio entero y usas la función de casi-duplicado con un umbral de similitud alto (Screaming Frog trae el 90 % por defecto).
Lo que buscas en el resultado: grupos de URLs con similitud alta, títulos y metadescripciones repetidos (síntoma barato y muy fiable), y URLs distintas que devuelven el mismo H1.
Antes de eso, una comprobación de treinta segundos: escribe a mano tu dominio con y sin www, con http y https, y con y sin barra final. Si las cuatro cargan sin redirigir, ya tienes trabajo.
Detección externa: quién te ha copiado
Coge dos o tres frases largas y poco comunes de tus mejores artículos y búscalas entre comillas en Google. Lo que salga que no seas tú, te ha copiado.
Con una herramienta de plagio automatizas lo mismo a escala.
Antes de reclamar, valora: si quien te copió tiene mucha menos autoridad, no te está haciendo daño real y el esfuerzo no compensa. Si te está superando en tu propio contenido, ahí sí hay que actuar.
Búsquedas manuales que siguen funcionando
Sin herramientas de pago, con operadores:
site:tudominio.com "frase literal de tu contenido"para ver cuántas de tus URLs contienen lo mismo.site:tudominio.com inurl:?para asomarte a tus URLs con parámetros.site:tudominio.com intitle:"título exacto"para localizar títulos repetidos.
Estas tres búsquedas cuestan un minuto y descubren más de lo que parece.
Search Console: el informe de páginas y la canónica elegida
En el informe de indexación de páginas, tres estados hablan de duplicados:
- «Duplicada: el usuario no ha indicado ninguna versión canónica»: la página duplica a otra, no declara canonical y Google ha elegido la otra. Esta no saldrá en la Búsqueda. Es el aviso de que te falta canonical.
- «Duplicada: Google ha elegido una versión canónica diferente a la del usuario»: has declarado una canónica y Google prefiere otra URL. Revisa si tus redirecciones, tu sitemap o el protocolo (http o https) apuntan a otra versión.
- «Página alternativa con etiqueta canónica adecuada»: la versión AMP o móvil apunta bien a su canónica, que está indexada. No tienes que hacer nada.
Con la herramienta de inspección de URLs comparas dos campos: «Declarada por el usuario como canónica» y «Seleccionada por Google como canónica». Cuando no coinciden, tienes el problema localizado con nombre y apellidos.
Herramientas para detectar contenido duplicado, comparadas
Screaming Frog
La referencia para detección interna. Trabaja en tres niveles, y conviene saber cuáles tienes:
- Duplicado exacto: agrupa las páginas idénticas. Funciona también en la versión gratuita, junto con los títulos y metas repetidos.
- Casi-duplicado: marca las páginas que superan un umbral de similitud, del 90 % por defecto y ajustable. Se activa en Config > Content > Duplicates y puedes excluir menú y footer en Config > Content > Area. Solo con licencia.
- Páginas semánticamente similares: usa embeddings de un modelo de IA (con tu propia API key) para encontrar páginas que dicen lo mismo con otras palabras, justo lo que el casi-duplicado no ve. También exige licencia.
Gratis hasta 500 URLs. Para cualquier sitio serio, la licencia es la herramienta.
Siteliner
Análisis rápido de duplicado interno sin instalar nada: te da un porcentaje de contenido duplicado del sitio y el listado de páginas afectadas.
Gratis hasta 250 páginas, con un escaneo por sitio cada 30 días. Excelente para un diagnóstico rápido o para enseñarle el problema a alguien que no es técnico.
Copyscape
El clásico para duplicado externo: le das una URL y te dice quién ha copiado ese contenido. La búsqueda gratuita enseña un máximo de 10 resultados; la versión Premium te deja además pegar un texto antes de publicarlo. Es la herramienta cuando el problema es de fuera hacia dentro.
Semrush y Ahrefs
Sus auditorías de sitio incluyen detección de duplicado dentro de un chequeo más amplio. La ventaja es que es continuo y con histórico: te avisa cuando aparece duplicado nuevo, en lugar de que tengas que acordarte de mirar.
Semrush marca como duplicadas las páginas con un 85 % de contenido idéntico, un umbral fijo. Y Ahrefs te da su auditoría gratis en Ahrefs Webmaster Tools si verificas tu web. En nuestra experiencia, menos finos que un crawler dedicado para el casi-duplicado, pero mucho mejores para vigilancia.
Cuál usar según el tamaño de la web
| Tamaño | Herramienta | Por qué |
|---|---|---|
| Hasta 250 páginas | Siteliner | Gratis, inmediato, suficiente |
| Hasta 500 páginas | Screaming Frog gratis | Duplicado exacto y títulos y metas repetidos |
| Más de 500, o si necesitas casi-duplicado | Screaming Frog con licencia | Umbral configurable y similitud semántica |
| Vigilancia continua | Semrush o Ahrefs | Alertas e histórico |
| Duplicado externo | Copyscape | Está diseñado para eso |
Cómo resolverlo
Canonical: cómo se usa bien y los tres errores típicos
La etiqueta rel="canonical" le dice a Google cuál es la versión buena. Es una señal, no una orden: si el contenido de las dos páginas difiere mucho, Google la ignora.
Los tres errores que más vemos:
- Canonical a una página distinta. Si el contenido no es equivalente, Google la descarta y tú crees que está resuelto.
- Canonical en cadena: A apunta a B y B apunta a C. Que apunte cada una a C.
- Canonical relativa mal construida o apuntando a una URL que redirige. Usa siempre la URL absoluta y final.
Un cuarto error que Google cita expresamente: no declares canónicas distintas con técnicas distintas, por ejemplo una en el HTML y otra en el sitemap. Y ten en cuenta el peso de cada señal: la redirección y la canonical son señales fuertes; incluir la URL en el sitemap, una débil.
Y una regla que se olvida: toda página debe llevar canonical, incluidas las que se apuntan a sí mismas. La autorreferencial evita sorpresas con parámetros.
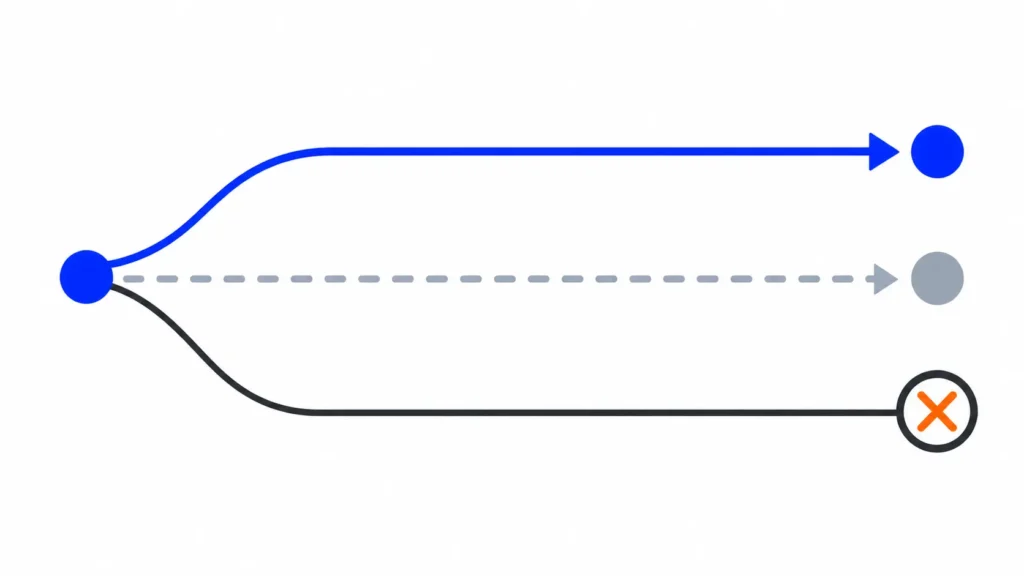
301 frente a canonical: cuándo cada uno
| Situación | Solución |
|---|---|
| Las dos URLs deben seguir existiendo para el usuario | Canonical |
| Solo debe existir una | 301 |
| Versiones con parámetro de campaña | Canonical a la limpia |
| Contenido movido o fusionado | 301 |
| Variantes de producto que el usuario necesita | Canonical al principal |
| http/www/barra final | 301 a nivel de servidor |
Cuando puedas usar 301, úsala: es la señal más fuerte que puedes dar, bastante más que la canonical.
noindex y cuándo NO usarlo
noindex saca la página del índice pero no consolida señales: si esa URL tenía enlaces externos, se pierden.
Úsalo cuando la página deba existir para el usuario y no aportar en búsqueda. No lo uses para consolidar duplicados que tienen autoridad: para eso está la 301.
Y no combines noindex con bloqueo en robots.txt. Si Google no puede rastrearla, no puede ver el noindex.
Consolidar contenidos que compiten entre sí
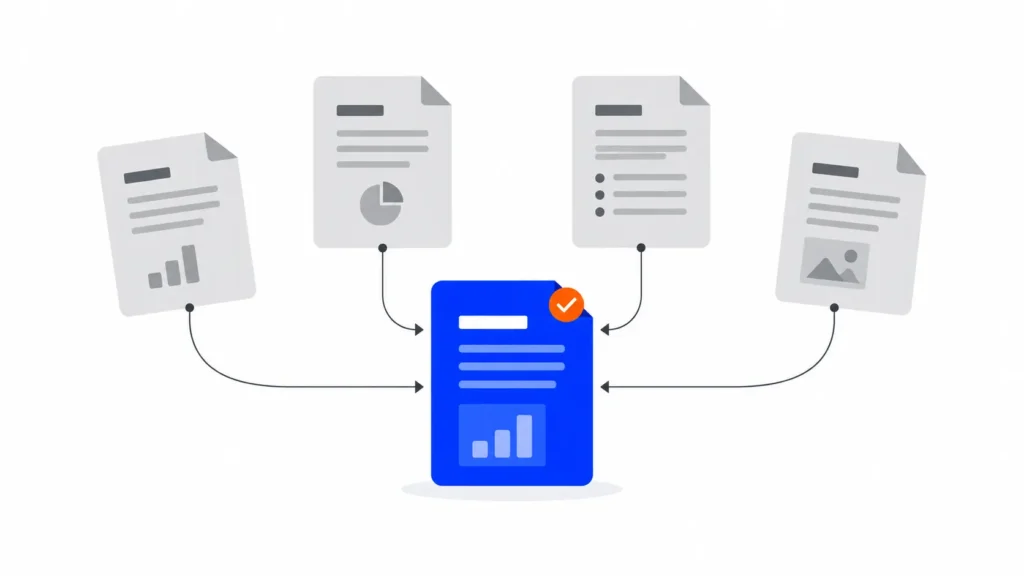
El caso más común y el que más tráfico devuelve: tres artículos sobre el mismo tema publicados en años distintos, ninguno rankeando bien porque se reparten las señales.
El procedimiento: identifica el grupo, elige la URL con más histórico (no la que más te guste), lleva a ella lo mejor de las otras, redirige con 301 1:1 y actualiza los enlaces internos que apuntaban a las viejas.
Ese último paso se olvida siempre y crea cadenas de redirección.
hreflang y duplicado entre idiomas
El mismo contenido en español para España, México y Argentina es duplicado técnico. Se resuelve con hreflang, que le dice a Google que son versiones regionales de lo mismo y cuál mostrar a cada usuario.
Requisito: los enlaces hreflang deben ser recíprocos. Si A declara a B y B no declara a A, Google ignora esa pareja de anotaciones. Y la canonical de cada versión tiene que apuntar a una página de su mismo idioma, nunca a la versión en otro idioma.
Duplicado creado por una migración
Las migraciones son la mayor fábrica de duplicado que existe, y el problema aparece meses después, cuando ya nadie relaciona una cosa con la otra.
Los tres patrones que se repiten:
- La web vieja sigue accesible. En un subdominio de pruebas, en una IP, o en un
staging.que nadie cerró. Contenido idéntico en dos sitios, y a veces el de pruebas ni siquiera tienenoindex. - Las URLs viejas responden 200 en lugar de redirigir, porque la migración se hizo montando la nueva encima sin retirar la anterior.
- Redirecciones a destinos aproximados: todo lo viejo apuntando a la home o a una categoría genérica. Google puede tratarlo como soft 404 y pierdes lo acumulado.
La comprobación es rápida: coge veinte URLs de la web anterior y compruébalas. Si devuelven 200, tienes duplicado. Si redirigen a la home, tienes pérdida de señales.
Mantén las redirecciones al menos un año, que es lo que recomienda Google para una migración.
Y una que se olvida siempre: comprueba que tu entorno de pruebas está bloqueado. Un staging indexado es tu web entera duplicada.
El caso del ecommerce
Merece sección propia porque concentra casi todos los tipos a la vez.
Variantes de producto
Un producto en cinco colores y seis tallas puede generar treinta URLs con el mismo texto. En general, canonical de todas las variantes al producto principal, salvo que exista demanda de búsqueda diferenciada real para una variante concreta.
Texto del fabricante en miles de fichas
Duplicado externo a escala: tienes lo mismo que otras cincuenta tiendas.
No hace falta reescribir todo. Prioriza por ventas y margen, y en la cola larga añade lo que ninguna otra tienda tiene: reseñas, preguntas de clientes, atributos reales, fotos propias. El detalle en SEO para ecommerce.
Facetas y filtros
La mayor fuente de duplicado interno de cualquier tienda. La política de qué faceta se indexa y cuál no se decide en la arquitectura, no parcheando canonicals después.
Contenido duplicado e IA
Contenido generado a escala y el riesgo de casi-duplicado
Generar cien descripciones con IA a partir de la misma plantilla produce cien textos con la misma estructura, el mismo tono y las mismas frases de transición. Técnicamente no son duplicados exactos, pero son casi-duplicados de manual.
Si generas a escala, varía la estructura y no solo las palabras, y revisa la similitud interna con el crawler antes de publicar, no después.
Qué versión cita un LLM cuando hay varias
Bing lo explicó en diciembre de 2025 en su blog oficial: los modelos agrupan las URLs casi duplicadas y eligen una sola página para representar el conjunto. Si las diferencias son mínimas, pueden quedarse con una versión antigua o con la que no querías destacar. Y con varias páginas parecidas, les cuesta saber cuál responde mejor.
En Google el mecanismo es más directo. Para salir como enlace en AI Overviews o en el Modo IA, una página tiene que estar indexada. Una duplicada que Google no elige como canónica no se muestra, así que tampoco puede ser la fuente citada. Su propia guía para la búsqueda con IA generativa pide reducir el contenido duplicado.
La solución es la de siempre: consolida. Canonical o 301 hacia la versión buena, y resolver el duplicado mejora tu posición y tus opciones de ser la fuente citada a la vez.
¿Cuánto duplicado tiene tu web?
Casi nadie lo sabe hasta que hace el crawl, y la cifra suele sorprender, sobre todo en tiendas y en webs con muchos años encima. Es una de las primeras cosas que revisamos en una consultoría SEO: detección, mapa de canonicals y plan de consolidación priorizado.
Consolidar funciona también a escala de dominio. Doña Coletas tenía dos webs, una para la tienda online y otra para la física, y las unificamos en una sola con arquitectura transaccional. En menos de tres meses: +130% de impresiones, +71% de clics y 293 keywords en el Top 3.
Preguntas frecuentes
¿El contenido duplicado penaliza en Google?
No existe una penalización por duplicado como tal. Lo que hay es un coste: Google elige una versión, las señales se reparten entre varias URLs y se gasta rastreo. Solo el duplicado masivo y manipulativo puede acarrear acción manual.
¿Cómo detecto el contenido duplicado de mi web?
Con un crawler y su función de casi-duplicado (Screaming Frog usa un 90 % de similitud por defecto). Para un diagnóstico rápido, Siteliner. Y comprueba a mano que las versiones con y sin www, con http y https y con y sin barra final redirigen a una sola.
¿Cuál es la mejor herramienta para detectar contenido duplicado?
Para duplicado interno, Screaming Frog. Para un chequeo rápido y gratuito hasta 250 páginas, Siteliner. Para saber quién te ha copiado, Copyscape. Para vigilancia continua, Semrush o Ahrefs.
¿Qué porcentaje de contenido duplicado es aceptable?
No hay umbral oficial, y cualquier cifra que te den es orientativa. Pero importa más qué páginas están afectadas que el porcentaje: duplicado en tus páginas de dinero es grave aunque sea poco.
¿Canonical o 301?
Canonical si las dos URLs deben seguir siendo accesibles para el usuario. 301 si solo debe existir una. Cuando puedas usar 301, úsala: es una instrucción y no se ignora.
¿Qué hago si me copian el contenido?
Valora si te está haciendo daño real. Si quien copia tiene mucha menos autoridad, normalmente no. Si te supera con tu propio contenido, empieza por contactar, y si no hay respuesta existe el procedimiento de retirada por derechos de autor de Google.
¿La sindicación de contenidos genera contenido duplicado?
Sí. Si otro medio publica tu artículo completo, hay dos versiones del mismo texto y la suya puede superarte. Pide que añadan una canonical apuntando a tu URL original o publica solo un extracto con enlace al artículo completo. Así las señales vuelven a tu página.
¿Por qué Google ignora mi etiqueta canonical?
Porque la canonical es una sugerencia, no una orden. Google la cruza con otras señales: redirecciones, sitemap, versión http o https. Si se contradicen, elige otra URL y en Search Console lo verás como «Duplicada: Google ha elegido una versión canónica diferente a la del usuario». Alinea todas las señales hacia la misma URL.
¿El contenido duplicado afecta a que la IA me cite?
Sí, de forma indirecta. Los modelos agrupan las versiones casi iguales y eligen una para representarlas, y en Google una página duplicada no elegida como canónica ni siquiera se muestra. Consolidar mejora a la vez tu posición y tus probabilidades de ser la fuente citada.